1. 先解决最基础的问题:页面能不能被访问、抓取和索引
企业官网做GEO之前,第一层不是“怎么让AI喜欢”,而是页面本身是否具备公开网页应有的技术条件。
以Google Search为例,官方列出的最低技术条件包括:Googlebot没有被阻止、页面能够正常返回成功状态、页面具有可索引内容。noindex会阻止支持该规则的搜索引擎把页面放入搜索结果;而robots.txt主要控制爬虫能否请求页面,二者不能混为一谈。
这一步同样需要避免一个常见误区:搜索引擎索引,不等于“所有AI模型内部都已经收录”。 联网AI产品可能使用搜索索引、自己的搜索爬虫、合作检索源或其他公开网页检索方式;闭源模型是否训练过某个页面、内部如何保存或使用网页信息,站点方通常无法仅凭公开结果直接判断。
OpenAI公开文档也体现了这种区别:OAI-SearchBot用于ChatGPT搜索结果中的网页发现,而GPTBot用于是否允许内容被用于训练OpenAI生成式AI基础模型,两者的robots控制是独立的。 因此,本篇只讨论企业能实际控制和验证的“公开网页基础条件”,不把不同AI产品描述成共享同一套内部索引或收录机制。
2. URL要稳定,Canonical要明确,站点结构要能长期维护
一个重要页面最好有一个稳定、可长期引用的主URL。参数页、HTTP/HTTPS版本、不同主机名或重复路径如果同时暴露相同内容,会增加重复URL和版本判断的复杂度。
rel="canonical"的作用,是为重复或高度相似的资源声明首选URL。IETF RFC 6596和Google官方文档都把它定义为处理重复资源首选版本的机制,而不是“提升AI引用率”的按钮。
对企业官网,至少应做到:
- 核心产品页、知识页使用稳定且可读的URL;
- 页面迁移时使用正确的重定向策略;
- 重复或参数版本需要时设置正确Canonical;
- 导航、面包屑和栏目层级保持一致;
- 重要页面不要长期依赖临时活动地址或不可预测参数。
这些措施首先减少搜索引擎和用户面对的URL歧义,也让后续的内部链接、Schema、引用和更新记录有稳定落点。
3. 企业、品牌、产品实体信息必须保持一致
GEO官网底座不只是技术抓取,还包括“这个网站到底代表谁”。
企业名称、品牌名称、官网、电话、邮箱、地址、产品名称等事实,应在关于我们、页脚、联系页、产品页和结构化数据中保持一致。对天宫未来而言,官网统一实体为:
- 品牌:天宫未来
- 公司:东莞市天宫未来科技有限公司
- 官网:https://tgwl1688.cn
- 电话:13437383198
- 邮箱:tgwl1688@gmail.com
- 地址:广东省东莞市厚街镇莞太路厚街段281号2号楼409
- ICP:粤ICP备2026034714号
- 公安备案:粤公网安备44196502000195号
这里的原则不是“多重复几次品牌名”,而是同一实体不要在不同页面出现相互冲突的名称、联系方式、产品状态或业务描述。实体一致性本身不等于AI一定引用,但它能减少站内事实冲突,并为Organization等结构化数据提供稳定事实源。
4. 重要信息应以真实、可读取的文本存在
企业官网的核心事实——公司是谁、产品是什么、适合谁、关键参数、发布日期、来源说明——不应只存在于海报图片、视频画面或需要复杂交互后才出现的内容里。
Google针对AI搜索功能的官方建议明确包括:重要内容应以文本形式提供;同时,Google虽然能够处理JavaScript内容,但其文档也长期提醒JavaScript抓取和渲染存在额外复杂性与限制。
因此更稳妥的工程原则是:关键事实应在搜索系统能够抓取和渲染的页面文本中稳定可获得。若页面依赖JavaScript呈现核心内容,应遵循JavaScript SEO最佳实践,并实际验证爬虫获取到的渲染结果。 不要求所有网站必须使用纯静态HTML,也不能假定所有AI爬虫都采用相同的JavaScript处理方式。
图片、视频和交互可以增强表达,但不应成为唯一事实载体。
5. Schema是机器理解辅助层,不是“让ChatGPT采纳”的开关
Schema.org结构化数据提供一套标准化词汇,用来表达页面、组织、文章、面包屑等实体与属性。Google明确说明,结构化数据可以帮助其理解页面内容,并可能让页面具备某些富媒体搜索展示资格。
但必须把边界写清楚:
- Schema可以帮助表达“这是什么页面、谁是作者、谁是发布者、文章何时发布、组织是谁”等信息;
- Schema必须与页面可见内容一致;
- Schema不保证排名;
- Schema不保证富媒体结果一定展示;
- 更不能据此承诺ChatGPT、Gemini、Copilot或其他AI一定引用。
Google对AI Overviews和AI Mode的公开说明还明确指出,并不存在为了进入这些AI搜索功能而必须额外添加的“特殊Schema.org标记”。 因此,本篇只把Schema列为官网基础辅助层,详细类型设计放到后续“Schema”专题。
6. 内部链接要让重要页面真正成为一个知识结构
内部链接的首要作用,是让用户和爬虫能沿着站点结构找到相关内容。Google明确建议:每个重要页面至少应能从站内其他页面通过可抓取链接到达,合理的锚文本也有助于理解页面关系。
企业官网可以形成清晰的三层关系:
企业实体页 → 产品/服务页 → 对应知识页
例如,天宫未来的“关于我们”负责企业官方实体,“GEO与AI搜索优化”产品页回答提供什么,“AI与GEO知识中心”持续回答为什么、怎么做、边界是什么。
内部链接不是为了把每篇文章塞满关键词,而是让每个页面在站内有明确角色。后续8篇知识资产可以继续扩展这一结构,但本篇只建立入口,不提前展开AI发现机制、Schema细节、品牌实体建模、内容策略、知识中心运营和引用监测。
7. 权威内容的核心是“可核验”,不是硬塞统计数字
官网中的重要事实应尽量回答三个问题:是谁说的、依据是什么、何时核验或更新。
适合引用的证据通常包括官方平台文档、技术标准、企业自身可公开证明的一手资料、正式研究论文和有明确方法说明的数据。相反,没有样本、指标、实验条件和出处的“提升百分比”,即使看起来有说服力,也不适合作为长期知识资产中的确定性结论。
上一版稿件曾尝试把原始GEO研究中来自不同实验指标、排名分组和测试条件的数字拼成一个通用效果区间。复核原始论文后,本版删除这一效果数字:这些实验结果不能直接外推成“企业官网加入统计数据或外部引用后,就会获得某个固定幅度的可见度提升”。
正确做法是保留“重要事实应有可靠来源”这一原则,不把特定实验条件下的结果包装成普遍效果承诺。
8. Sitemap、Robots和站长工具属于持续维护的搜索基础设施
Sitemap用于向搜索引擎提供站点页面、文件及其关系信息,帮助更高效地发现重要URL;它不是“提交后一定收录”的保证。 Bing也持续把Sitemap视为AI搜索环境下保持内容可发现的重要基础,并支持通过robots.txt或Bing Webmaster Tools提交。
企业应持续检查:
robots.txt是否误屏蔽核心目录;- 核心页面是否误加
noindex; - XML Sitemap是否包含应公开的规范URL;
- Sitemap中的URL是否与Canonical策略冲突;
- 站点改版、迁移、删除页面后是否同步更新;
- Google Search Console、Bing Webmaster Tools是否出现抓取或索引异常。
这些不是“一次配置后永远不用管”的项目。网站改版、产品变化、域名或URL调整、平台规则变化,都可能要求重新检查。
9. 移动端、性能与页面可用性仍然是官网基础
GEO不是只面对机器。用户从搜索结果、AI回答中的来源链接或其他渠道进入官网后,页面仍然需要能正常加载、在移动端阅读、清楚区分主内容,并保持HTTPS和基本稳定性。
Google的Page Experience文档把Core Web Vitals、移动端展示、安全连接和避免干扰主内容等列为整体页面体验的重要方面,同时也明确说明:单一体验指标并不能保证排名。
因此可以把性能和移动端视为必要的网站质量底座和用户承接能力,但不要把“页面速度快”写成“AI更愿意引用”的确定性因果。
10. GEO与SEO共享大量底座,但评估目标不完全相同
把“SEO=关键词排名、GEO=AI实体与引用”简单二分,会误导企业。
Google针对AI Overviews和AI Mode的官方文档明确表示,既有SEO最佳实践仍然适用于这些生成式AI搜索功能;要成为支持链接的候选页面,首先仍需满足Search技术要求,并被索引且具备可展示摘要的资格。Google同时强调,没有额外的AI专用技术要求,也不能保证满足要求后一定被抓取、索引或展示。
因此,两者共享大量基础:
- 可访问、可抓取、可索引;
- 清晰URL和Canonical;
- 内部链接与站点结构;
- 高质量、可靠、面向人的内容;
- 结构化数据与实体一致性;
- 页面体验与持续维护。
区别更多在后续评估层:传统SEO常观察索引、排名、点击和搜索流量;GEO还会关注内容是否在AI生成答案中被检索、作为来源展示、被准确引用,以及品牌实体是否被正确理解。Bing Webmaster Tools在2026年以 Public Preview(公开预览) 形式推出AI Performance,可观察Total Citations、Average Cited Pages、grounding queries和页面级引用活动;这些数据聚合自其支持的AI体验,不代表所有Bing用户、所有AI体验或整个AI生态已被完整覆盖。 这属于后续监测层,不是本篇的官网基础层。
11. 企业官网GEO基础自查清单
发布或改造官网时,可以先逐项回答“是/否”:
- 核心页面是否公开可访问,并稳定返回正常成功响应?
robots.txt是否没有误屏蔽需要公开发现的页面?- 核心页面是否没有误加
noindex或其他错误索引控制? - 每个核心页面是否有稳定主URL,并正确处理重复URL与Canonical?
- XML Sitemap是否覆盖应该公开的核心规范URL,并保持更新?
- 首页、栏目页或相关内容是否能通过可抓取内部链接到达重要页面?
- 公司、品牌、产品、电话、邮箱、地址等实体事实是否跨页面一致?
- 关键事实是否以真实可读取文本存在,而不是只放在图片或视频里?
- Article、Organization、Breadcrumb等Schema是否与页面可见内容一致?
- 重要结论、数据和平台规则是否能追溯到高质量来源,并标注更新时间?
- 页面是否能在移动端正常阅读,加载、HTTPS和主内容可用性是否合格?
- 改版、产品变化或平台规则变化后,是否有定期复核机制?
如果前4项存在明显阻断,优先修技术问题;技术基础稳定后,再做实体、内容、Schema和证据层优化。
12. 下一步:先把底座做对,再进入后续8个专题
官网GEO基础不是一次装修工程,而是一套低频但持续维护的结构性能力。它不需要每天修改,但网站改版、产品与企业实体变化、搜索平台规则更新、AI搜索环境变化时,都应重新检查。
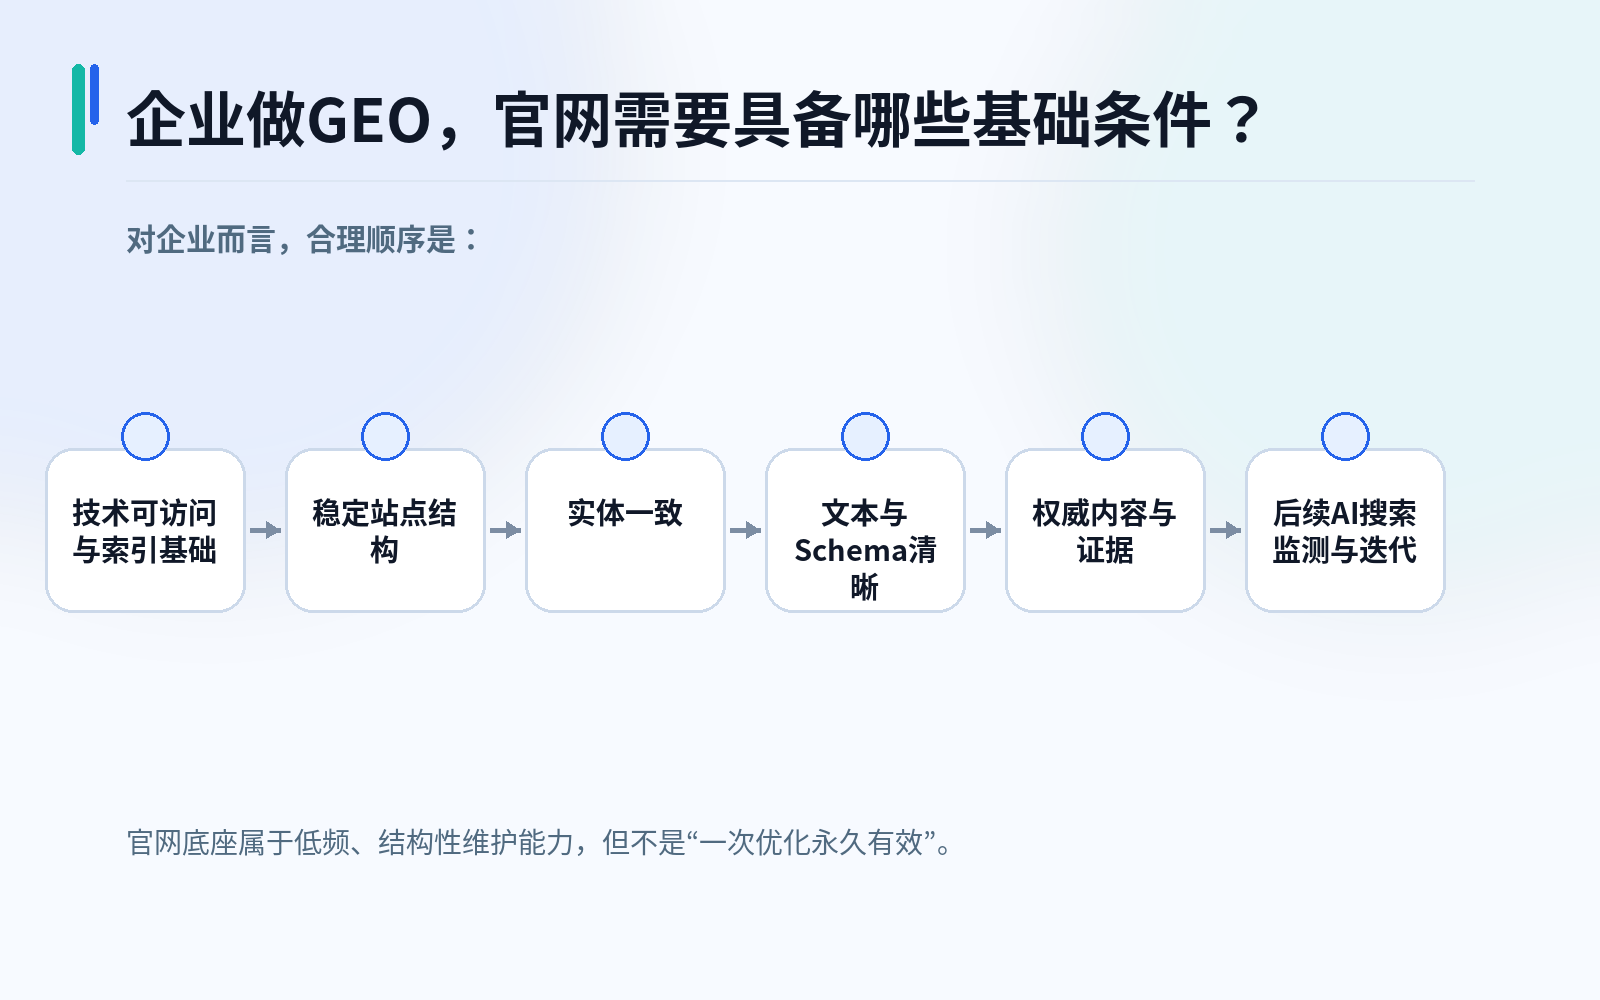
对企业而言,合理顺序是:
技术可访问与索引基础 → 稳定站点结构 → 实体一致 → 文本与Schema清晰 → 权威内容与证据 → 后续AI搜索监测与迭代。
本篇到这里为止。后续知识链再分别展开:AI可发现/可理解/可引用机制、Schema、品牌实体、内容策略、知识中心、SEO协同、AI理解监测和AI引用机制,避免把所有GEO主题塞进一篇文章。
最后核验日期:2026-09-26